

فهرست مطالب
پایگاه داده ستون فقرات نرمافزارهای مدرن است؛ از پلتفرمهای تجارت الکترونیک گرفته تا سیستمهای سازمانی، همه برای ذخیره و سازماندهی سریع اطلاعات به یک ساختار داده قابلاعتماد تکیه دارند. با این حال، پیادهسازی یک دیتابیس پایدار، فراتر از نوشتن چند کوئری ساده است و به درک عمیق معماری داده نیاز دارد.
با وجود ابزارهای آماده و پلتفرمهای کمکد، پروژههای جدی هنوز به ساخت دیتابیس سفارشی از صفر نیاز دارند. تکیه بر سیستمهای از پیش ساخته شده، تیم فنی را به فرضیات دیگران محدود میکند؛ درحالیکه تسلط بر اصول طراحی و مدیریت پایگاه داده پیش از شروع کدنویسی، امکان مدلسازی دقیق بر اساس منطق واقعی کسبوکار را فراهم میسازد. این رویکرد به توسعهدهندگان کنترل دقیق بر قوانین و ساختارها میدهد. در نتیجه، امنیت از پایه در معماری سیستم لحاظ میشود و مقیاسپذیری هدفمند نرمافزار برای بارهای تراکنشی سنگین آینده شکل میگیرد.
گام اول؛ تحلیل نیازمندیها و مدلسازی دادهها پیش از کدنویسی
طراحی پایگاه داده رابطهای، فرآیندی طراحیمحور است که پیش از باز کردن محیط کوئرینویسی و نوشتن حتی یک خط کد SQL آغاز میشود. در این فاز معماری، هدف اصلی این است که منطق واقعی کسبوکار به یک ساختار منطقی و قابل اجرا تبدیل شود. برای رسیدن به چنین نقشهای، تیم فنی باید در گام نخست به سه پرسش بنیادین پاسخ دهد. سوال اول این است که چه دادههایی با چه نوعی، مانند متن، عدد یا تصویر، و در چه حجم تقریبی قرار است ذخیره شوند. سوال دوم به الگوی مصرف کاربران برمیگردد؛ یعنی باید مشخص شود که سیستم به گزارشهای پیچیده نیاز دارد یا دسترسی سریع به اطلاعات خاص در اولویت است. سوال سوم نیز نحوه اتصال و ارتباط این دادهها را با یکدیگر مشخص میکند.
برای درک عینی این مرحله، سناریوی طراحی دیتابیس یک فروشگاه آنلاین را در نظر بگیرید. در این سیستم با سه موجودیت اصلی از دنیای واقعی روبهرو هستیم که هر کدام ویژگیهای مشخصی دارند:
- محصولات شامل نام، قیمت و تعداد موجودی
- مشتریان شامل نام، آدرس و اطلاعات تماس
- سفارشها شامل تاریخ، جزئیات خرید و وضعیت پرداخت
در مرحله مدلسازی دادهها، این موجودیتها تفکیک میشوند و نحوه تعامل آنها، مانند ثبت سفارش توسط یک مشتری یا قرار گرفتن محصولات درون آن سفارش، روی کاغذ میآید. تصمیماتی که در همین روز اول برای تعریف نوع دادهها، روابط و کنترل دسترسیها گرفته میشود، سرعت پاسخگویی و مقیاسپذیری نرمافزار را در آینده رقم میزند. همین طراحی اولیه اجازه میدهد امنیت و رمزگذاری به همراه سازوکارهای ردیابی در بنیاد سیستم لحاظ شوند تا نیازی نباشد پس از رخ دادن یک نقص امنیتی، به فکر اصلاح ساختار بیفتید.
اجزای اصلی در طراحی طرحواره پایگاه داده
طرحواره یا Schema، چارچوب معماری دیتابیس است که مشخص میکند دادهها چطور ذخیره شوند و به هم لینک بخورند. برای پیادهسازی یک طراحی پایگاه داده رابطهای، ابتدا باید بلوکهای سازنده آن را به درستی تعریف کرد:
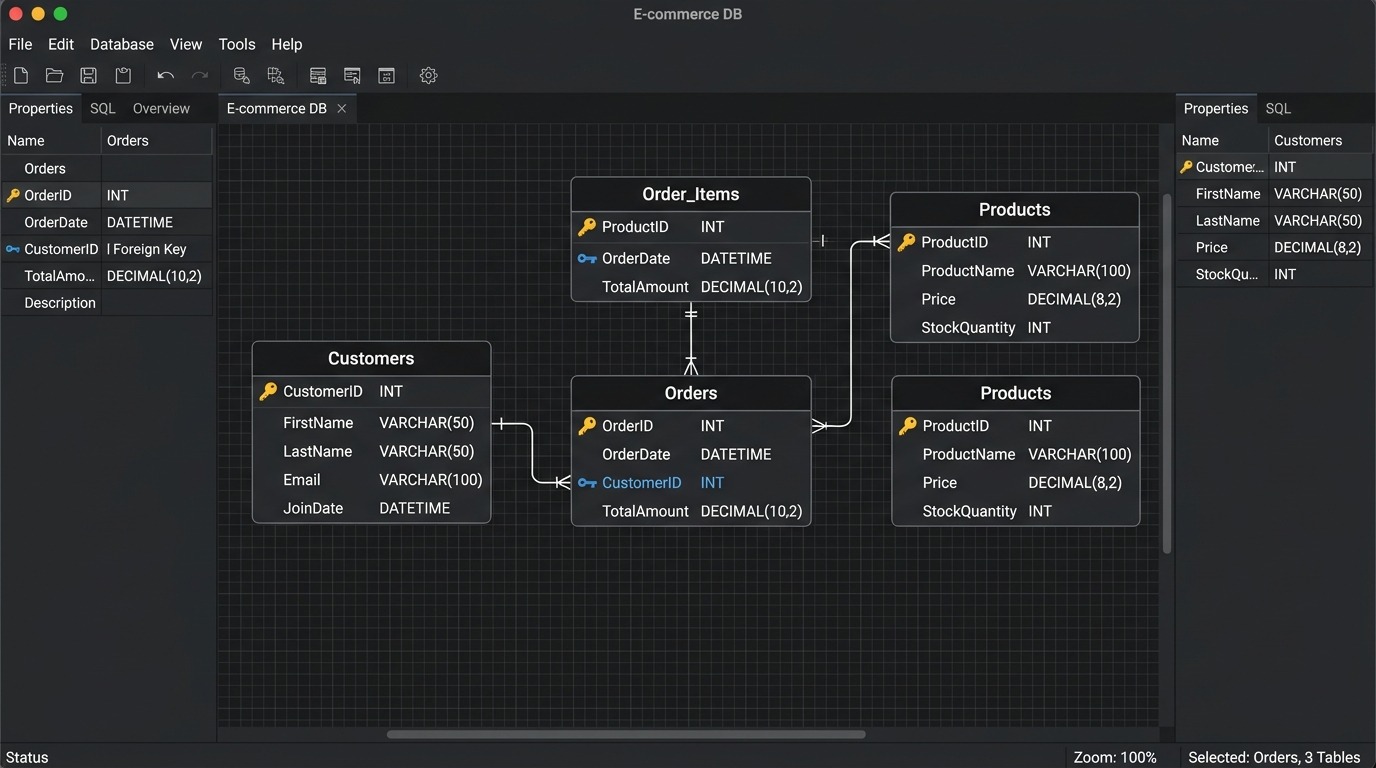
- جدولها و ستونها که دادهها را بر اساس موضوعات مشخص مثل مشتریان یا محصولات گروهبندی میکنند. هر جدول از ردیفها و ستونها تشکیل میشود؛ هر ردیف یک رکورد متمایز است و هر ستون ویژگی خاصی از داده مانند نام یا ایمیل را با نوع داده و محدودیتهای مشخص نگه میدارد تا از ورود اطلاعات ناهماهنگ جلوگیری شود.
- کلید اصلی یا Primary Key که شناسهای برای تضمین یکتا بودن هر رکورد در داخل یک جدول است.
- کلید خارجی یا Foreign Key که فیلدی برای ارجاع به کلید اصلی در جدول دیگر است. این کلیدها یکپارچگی ارجاعی را اعمال میکنند و پایه اجرای پیوستهای قابلاعتماد بین جداول هستند.
- انواع روابط که اتصالات منطقی بین جدولها را بدون نیاز به تکرار اطلاعات شکل میدهند. این ارتباطات شامل رابطه یکبهیک و رابطه یکبهچند مثل یک مشتری با چندین سفارش است. رابطه چندبهچند هم مانند حضور محصولات مختلف در چندین سفارش، از طریق یک جدول ترکیبی پیادهسازی میشود.
ترسیم این ساختار پیش از کدنویسی، درک مدل داده را سادهتر میکند. ابزار گرافیکی DB Designer برای طراحی بصری اولیه جداول، کلیدها و روابط کاربرد زیادی دارد. اگر پروژه بزرگ باشد و به همکاری آنلاین و همزمان تیمها نیاز پیدا کند، Lucidchart گزینه مناسبی برای رسم نمودارها است. همچنین در سطح حرفهایتر، نرمافزار ER/Studio به مدلسازی دادهها و مستندسازی دقیق پایگاههای داده رابطهای کمک میکند.
گام دوم؛ انتخاب سیستم مدیریت پایگاه داده مناسب پروژه
هر پایگاه داده توسط یک سیستم مدیریت پایگاه داده یا DBMS کنترل میشود؛ نرمافزاری که وظیفه ساختاردهی به اطلاعات و پاسخ به پرسوجوها را در کنار ایندکسگذاری و اجرای قوانینی مانند یکتایی و یکپارچگی ارجاعی بر عهده دارد. انتخاب بستر مناسب در این مرحله مشخص میکند که دادههای پروژه در عمل چگونه ذخیره و بازیابی شوند.
زمانی که پروژه با دادههای غیرساختاریافته یا نیمهساختاریافته سروکار دارد، ابزارهای غیررابطهای یا NoSQL وارد میدان میشوند؛ اما برای مدیریت دادههای ساختاریافته در قالب جداول و تعامل از طریق زبان SQL، باید سراغ سیستمهای مدیریت پایگاه داده رابطهای رفت. سه گزینه اصلی در این حوزه بر اساس مقیاس و نیاز فنی پروژه به شکل زیر تفکیک میشوند:
- سیستم MySQL که رایگان و محبوب است و به دلیل سادگی در استفاده و کارایی مناسب، اغلب در پروژههای کوچک و متوسط به کار میرود. پشتیبانی از دادههای پیچیده در کنار راهاندازی سرراست، آن را به انتخابی رایج برای برنامههای تحت وب تبدیل کرده است. برای تسلط بر این ابزار پرکاربرد میتوانید به صفحه maktabkhooneh.org/learn/mysql مراجعه کنید و مباحث مرتبط با آن را گامبهگام پیش ببرید.
- موتور PostgreSQL که برای پروژههایی با مقیاس بزرگتر، انعطافپذیری بالاتر و پردازش دادههای پیچیدهتر گزینه مناسبی به شمار میرود. این سیستم رابطهای پیشرفته به خاطر مقیاسپذیری و قابلیتهایی مانند مدیریت تراکنشهای پیچیده و ذخیرهسازی دادههای جغرافیایی شناخته میشود.
- سیستم SQL Server که محصول مایکروسافت است و برای سیستمهای بزرگ سازمانی و نیازهای تجاری در مقیاس وسیع توسعه یافته است. این بستر امکانات مدیریتی و امنیتی قدرتمندی را در اختیار تیمهای فنی قرار میدهد.
سنجش دقیق ابعاد پروژه و پیچیدگی تراکنشها پیش از شروع کدنویسی، به تیم توسعه کمک میکند تا از تغییر پرهزینه زیرساخت دادهای در میانه راه جلوگیری کند.
گام سوم؛ پیادهسازی عملی و اجرای دستورات پایه در SQL
پس از نهایی شدن طراحی و انتخاب موتور، نوبت به کدنویسی و اجرای دستورات ساخت دیتابیس در SQL میرسد. پیادهسازی در SQL یک منطق ترتیبی مشخص دارد؛ ابتدا باید خود پایگاه داده را بسازیم و آن را به عنوان محیط فعال انتخاب کنیم تا در مرحله بعد نوبت به تعریف جداول و ذخیره رکوردها برسد. تا زمانی که دیتابیس ایجاد و انتخاب نشده باشد، امکان ساخت مستقیم جدول در آن وجود ندارد.
پیش از اجرای کدها، باید چند پیشنیاز و محدودیت فنی را در نظر گرفت. کاربر اجراکننده کوئری به مجوز دسترسی ویژه در دیتابیس اصلی نیاز دارد؛ چراکه برای کنترل فضای دیسک، معمولاً این دسترسی تنها به کاربران محدودی داده میشود. نام انتخابی برای پایگاه داده نیز باید در سرور یکتا باشد و قوانین شناسه را با طول حداکثر ۱۲۸ کاراکتر رعایت کند. همچنین دستور ساخت دیتابیس باید در حالت خودکار یا Autocommit اجرا شود تا سیستم تغییرات را بهصورت خودکار ذخیره کند و سرور درگیر پردازش دیگری نباشد.
مدیران پایگاه داده دو اقدام پیشگیرانه را هم پیش از اعمال تغییرات توصیه میکنند. مورد اول، تهیه نسخه پشتیبان از دیتابیس سطح Master پیش از ساخت، تغییر یا حذف هر دیتابیس کاربری است. مورد دوم، تنظیم اندازه فایلهای دادهای در زمان ایجاد پایگاه داده است تا فضای کافی برای پشتیبانی از حجم اطلاعات آینده وجود داشته باشد.
ساخت، انتخاب و حذف پایگاه داده
برای ایجاد یک پایگاه داده جدید روی سرور، عبارت `CREATE DATABASE` را همراه با نام یکتای مورد نظر اجرا میکنیم:
sql
CREATE DATABASE database_name;
پس از ساخت دیتابیس، باید آن را به عنوان پایگاه داده فعال مشخص کنیم تا کوئریهای بعدی و عملیات ساخت جدول به طور پیشفرض روی همین فضا اجرا شوند:
sql
USE databasename;
در صورتی که در مراحل توسعه یا تست نیاز به پاک کردن کامل یک پایگاه داده از روی سرور باشد، فرمان `DROP DATABASE` به همراه نام دیتابیس به کار میرود:
sql
DROP DATABASE databasename;
در تمامی این دستورات، قرار دادن کاراکتر سمیکالن در انتهای خط، پایان فرمان SQL را به موتور پایگاه داده اعلام میکند.
ایجاد جداول و درج دادههای اولیه
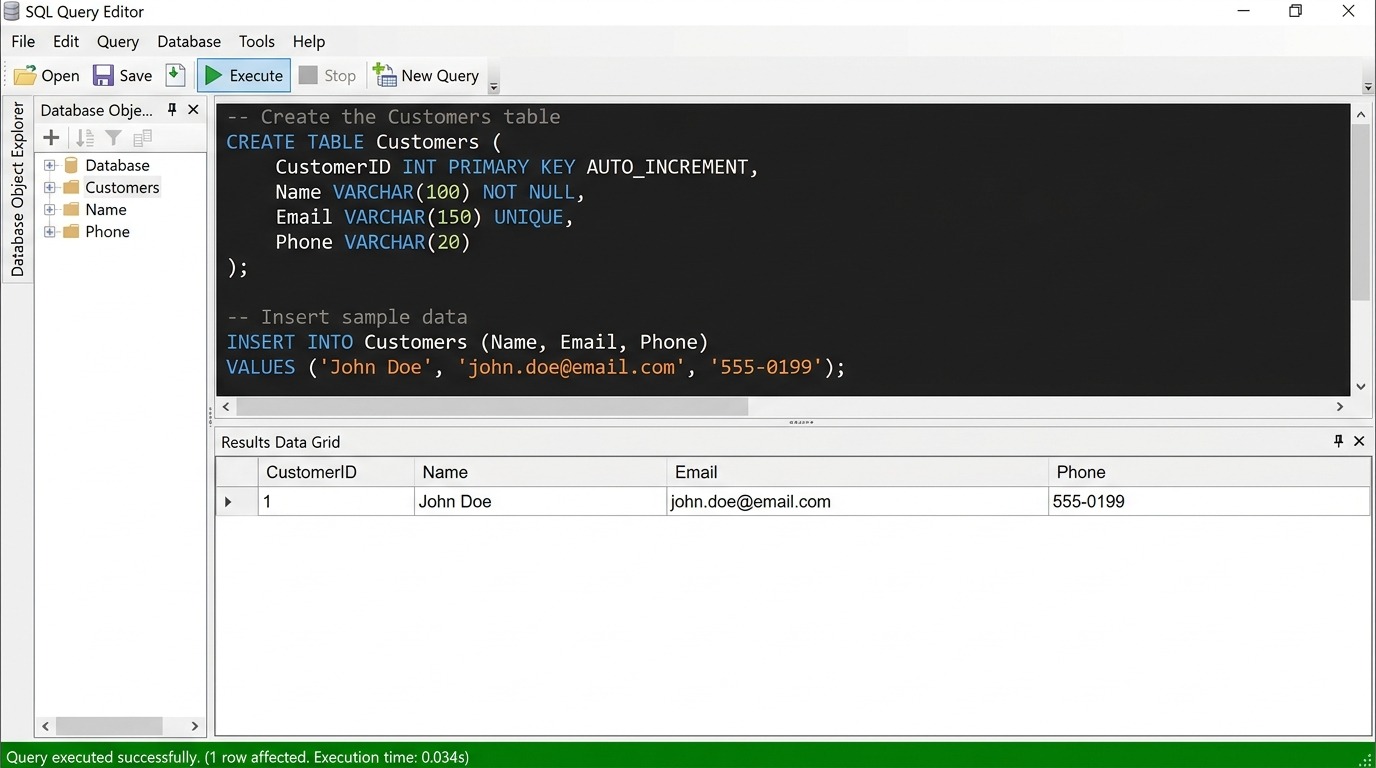
پس از ساخت و انتخاب پایگاه داده، نوبت به پیادهسازی جداول طراحیشده در سناریوی فروشگاه آنلاین میرسد. برای ساخت جدول مشتریان، از دستور `CREATE TABLE` استفاده میکنیم و ستونها، نوع دادهها و کلید اصلی را به شکل زیر تعریف خواهیم کرد:
sql
CREATE TABLE Customers (
CustomerID INT PRIMARY KEY,
Name VARCHAR(100),
Email VARCHAR(100),
Phone VARCHAR(15)
);
در این قطعه کد، فیلد `CustomerID` با نوع داده عددی `INT` به عنوان کلید اصلی تعیین شده است تا هر مشتری شناسه یکتایی داشته باشد. برای فیلدهای نام، ایمیل و شماره تلفن نیز از نوع متنی `VARCHAR` با سقف کاراکتر مشخص استفاده کردهایم تا از ورود دادههای ناهماهنگ جلوگیری شود.
وقتی ساختار جدول آماده شد، نوبت به ذخیرهسازی رکوردها میرسد. برای افزودن یک مشتری نمونه به جدول ساختهشده، دستور `INSERT INTO` را به کار میبریم:
sql
INSERT INTO Customers (CustomerID, Name, Email, Phone)
VALUES (1, ‘John Doe’, ‘john.doe@example.com’, ‘123-456-7890’);
وارد کردن دادهها همیشه به شکل دستی انجام نمیشود. در پروژههای نرمافزاری، فرآیند نصب و بازطراحی پایگاه داده و آمادهسازی آن برای استفاده، استقرار یا Deployment نام دارد. تیمهای فنی برای مدیریت خودکار این مرحله از اسکریپتهای پیش از استقرار و پس از استقرار کمک میگیرند. اسکریپتهای پیش از استقرار، محیط را قبل از اعمال تغییرات آماده میکنند و اسکریپتهای پس از استقرار، بلافاصله بعد از ساختهشدن جداول اجرا میشوند تا دادههای اولیه مورد نیاز سیستم یا همان Seed Data را به شکل خودکار با دستورات درج، درون پایگاه داده قرار دهند.
گام چهارم؛ بهینهسازی، امنیت و نگهداری در محیطهای عملیاتی مدرن
ساخت جداول و درج دادهها پایان کار نیست؛ پایگاه داده در محیط واقعی تحت فشار ترافیک و افزایش حجم اطلاعات قرار میگیرد و بدون نگهداری مستمر، سرعت اولیه خود را از دست میدهد.
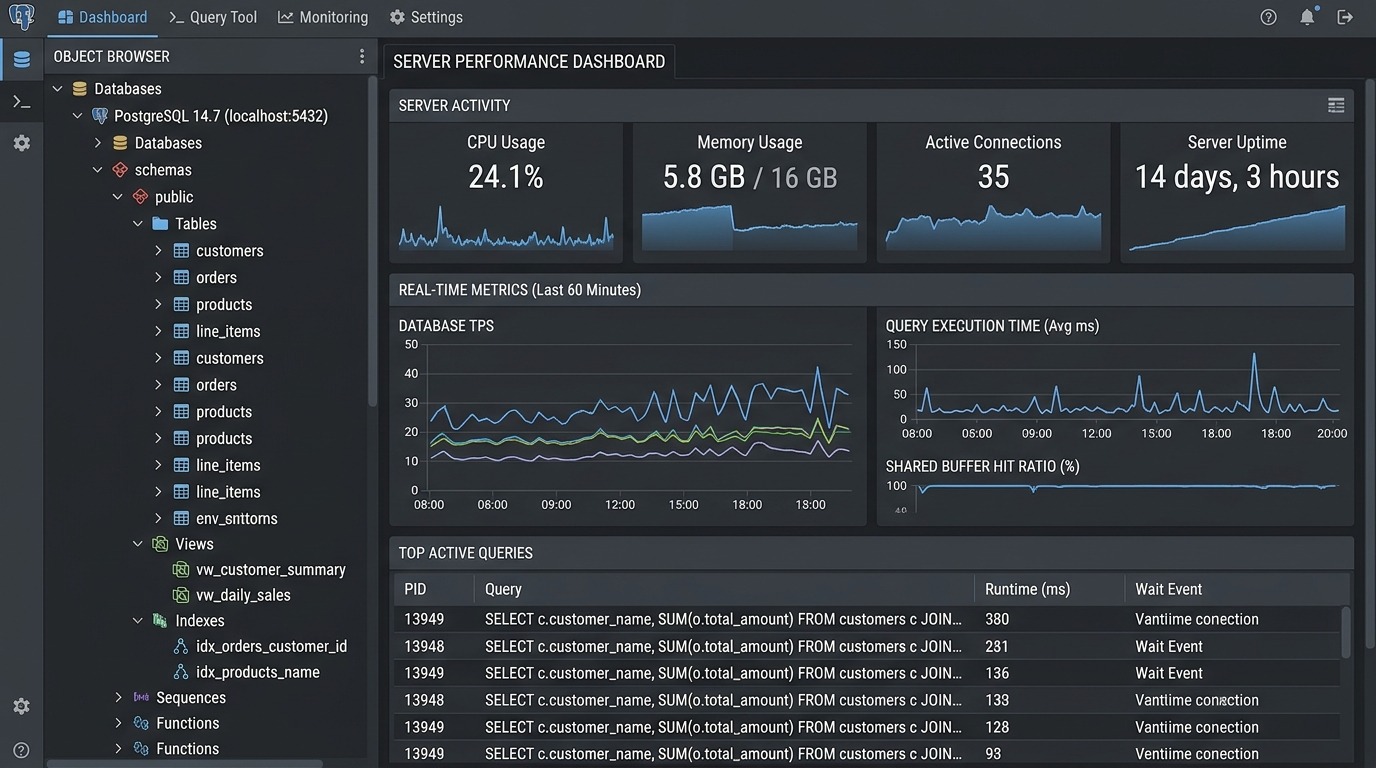
اولین اقدام فنی برای حفظ سرعت پاسخدهی و بهینهسازی پایگاه داده، تعریف هدفمند ایندکسها است. ایندکس به موتور دیتابیس اجازه میدهد بدون نیاز به اسکن کامل جدول، رکوردهای مورد نظر را با سرعت بیشتری بازیابی کند و بار کوئریها را در مجموعهدادههای بزرگ کاهش دهد:
- ایندکسهای تکستونی برای فیلدهایی با تکرار بالای جستجو مانند `Email` یا `OrderDate`.
- ایندکسهای ترکیبی برای پشتیبانی از فیلتر کردن یا مرتبسازی همزمان روی چندین فیلد.
- ایندکسهای متن کامل برای جستجوی سریع کلمات کلیدی درون ستونهای متنی بزرگ.
در کنار سرعت، مدیریت دسترسی و سادهسازی ساختار کوئریها با استفاده از نماها یا همان View انجام میشود. نماها جداول مجازی ساختهشده از کوئریهای ذخیرهشده هستند که پیوستهای پیچیده بین چند جدول را پنهان میکنند. با تعریف نما میتوان فیلدهای حساس را از دید کاربران عادی مخفی نگه داشت و لایههای دسترسی به داده را بر اساس نقش هر کاربر، برای کارهایی مثل گزارشگیری و تحلیل تنظیم کرد.
پایداری سیستم در بلندمدت به پایش مداوم عملکرد و بررسی زمان اجرای کوئریها در کنار تهیه منظم نسخههای پشتیبان وابسته است تا دادهها در برابر خطاهای احتمالی محافظت شوند. برای اجرای راحتتر این وظایف، ابزارهای مدیریتی متناسب با هر موتور به کار میروند؛ از جمله SSMS برای SQL Server و همچنین phpMyAdmin و pgAdmin که به ترتیب برای MySQL و PostgreSQL استفاده میشوند. همچنین در معماریهای نرمافزاری جدید، استقرار پایگاههای داده و سرویسها روی زیرساختهای ابری و کانتینری برای رسیدن به مقیاسپذیری بالا اهمیت زیادی دارد و توسعهدهندگان برای مدیریت این محیطها به سراغ مباحثی چون آموزش کوبرنتیز میروند. ترکیب این ابزارهای مدیریتی با پایش مستمر کوئریها، کارایی پایگاه داده را همزمان با رشد کاربران حفظ میکند.
جمعبندی
عبور از مراحل ساخت پایگاه داده، از تحلیل نیازمندیها و مدلسازی روابط تا انتخاب سیستم مدیریت دیتابیس، اجرای دستورات SQL و پیادهسازی تکنیکهای بهینهسازی در زمان استقرار، نشان میدهد که این کار فراتر از نوشتن چند کوئری ساده است. زمانی که معماری جداول، کلیدها و ایندکسها از روز اول بر اساس منطق واقعی پروژه چیده شود، تیم فنی کنترل دقیقی بر یکپارچگی و امنیت دادهها خواهد داشت؛ اقدامی که یک سرمایهگذاری مستقیم روی کارایی و پایداری نرمافزار در آینده محسوب میشود.